
把五六个网站塞进同一台主机,最怕的不是流量大,而是其中一个站突然把 CPU 和内存吃光,其余站全部跟着遭殃。这篇文章解决一个很具体的问题:多站点共用一台主机时,如何做资源隔离,才能让某个站点的进程限制和流量峰值不波及邻居。下面按「先诊断、再限进程、后扛峰值」的顺序展开,每一步都给出可执行的命令和判断标准,帮助你快速定位瓶颈而不是靠重启碰运气。
一、先搞清楚共用主机的资源边界
很多站长以为买了 4 核 8G 套餐就拥有 4 核 8G,实际上在共享虚拟主机或未做隔离的 VPS(虚拟专用服务器,把一台物理机切成多个独立小服务器)上,这只是”名义上限”。先确认主机属于哪一档,隔离手段完全不同。
- 共享虚拟主机:面板限制每账户的 CPU 秒数和并发进程数(常见 20-30 个),超出返回 508/503,只能做应用层优化。
- 无隔离的 VPS:商家超售时,其他租户的突发负载会通过 CPU steal time(被宿主机挤占的时间)波及你。
- 有隔离机制的方案:容器或虚拟化层对 CPU、内存、IOPS 有硬限额(如 KVM 独享核心),隔离真正可控。
判断处于哪一档有两个快速检查:一是在主机上跑 top 并按 1 展开每核负载,%st 长期高于 5% 说明宿主机超售,判定细节见 VPS CPU steal 超售检测指南;二是用 ab -n 2000 -c 50 https://你的域名/ 压测静态页,出现大量非 2xx 的临界值就是服务商划下的并发红线。
明确了边界,隔离动作才有意义——共享主机上做系统级限制是徒劳的,重点要放在应用层。
二、限制每个站点的进程数量
进程失控是多站点环境的头号杀手:一个配置错误的 PHP 站点可以瞬间拉起上百个 worker,把同主机其他站的请求全部挤掉。隔离第一步就是把每站进程数钉死。
Nginx + PHP-FPM 架构(VPS 常见)给每个站点独立 FPM pool,在 /etc/php/8.2/fpm/pool.d/siteA.conf 中写入:
[siteA]
user = siteA
listen = /run/php-fpm-siteA.sock
pm = dynamic
pm.max_children = 10
pm.start_servers = 2
pm.min_spare_servers = 2
pm.max_spare_servers = 4
pm.max_requests = 500
配置含义:siteA 最多 10 个 PHP 进程,每进程处理 500 个请求后自动回收防内存泄漏。4 站同配时 PHP 进程总数锁死在 40 以内,按每进程 60-80MB 估算仅 PHP 占 2.4-3.2G,剩余足够 Nginx、MySQL 和系统开销。日志频繁出现 server reached pm.max_children 说明该站需要更多资源,应升配额而非放开全局限制。
cPanel 类共享主机没有 FPM 配置权限,替代手段是压低应用层消耗:把 wp-cron.php 改为系统 cron 触发(间隔 15 分钟),插件数压到 20 个以内——实测每多一个低质量插件平均增加 3-6% 的 PHP 执行时间;Memory Limit 也不要统一拉到 512M,主站 256M、展示站 128M 的差异化设置本身就是软隔离。
验证隔离是否生效:ps -eo user,pid,pcpu --sort=-pcpu | grep -v root | head -20,确认每站进程数不超上限。若某站仍越界,检查是否有 CLI 脚本绕过了 FPM 需单独限流;另外各站备份不要都设在同一整点,cron 错峰到第 5、15、25、35 分钟是零成本的隔离动作。
三、应对单站流量峰值的三道防线
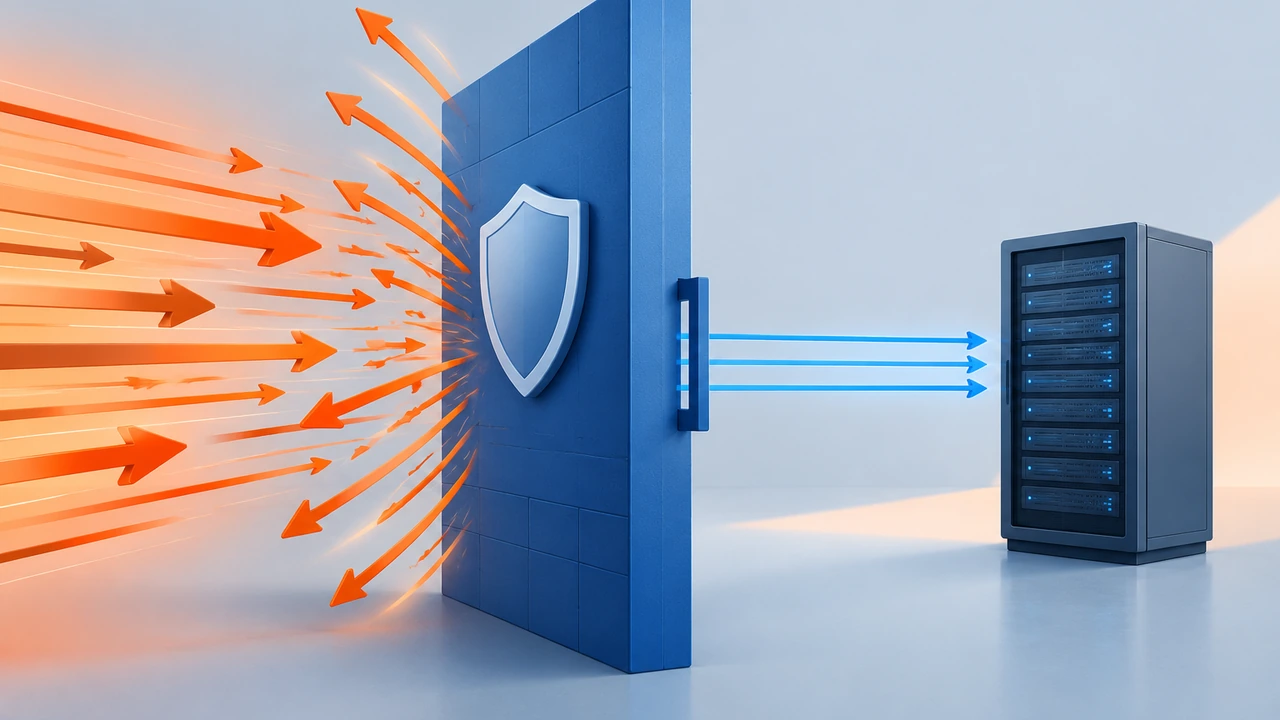
进程限制解决”稳态互不干扰”,但流量峰值是另一回事:某站被外链引流或遭遇采集时,瞬时请求可放大 10 倍以上,没有预案的主机峰值一来就是全站 502。
第一道防线:CDN 吸收静态与突发流量。 把图片、CSS/JS 全部走 CDN(内容分发网络,把静态资源缓存到离访问者更近的节点)后,回源请求通常下降 60-80%;即使源站短暂 502,已缓存页面仍可访问。中美线路选型可参考 CDN 与直连的中美路由实测。
第二道防线:站点级限流。 在 Nginx 的站点 server 块中按来源 IP 限制请求速率,把突发请求放进小缓冲队列:
limit_req_zone $binary_remote_addr zone=siteA_req:10m rate=10r/s;
server {
    ...
    location / {
        limit_req zone=siteA_req burst=20 nodelay;
    }
}
即 siteA 对单个 IP 限速每秒 10 个请求、允许 20 个突发排队。有了它,被采集的站点最多消耗自己的配额,不会把整台机器的带宽(单位时间可传输的数据量)和 CPU 打满;共享主机用户可用缓存插件的限流规则实现类似效果。
第三道防线:队列化重任务。 峰值时最伤的不是页面请求,而是同周期触发的导出、群发、缩略图生成,把它们改为异步队列并单独设 CPU 配额。三道防线的优先级是 CDN > 限流 > 队列化:CDN 挡住量,限流管住越界,队列化保住关键路径,按序部署后邻居站的冲击通常可控在个位数百分比。
四、方案对比:什么规模用什么隔离手段
隔离手段没有最好只有最合适,关键变量是站点数量、预算和运维能力。四种常见方案按同一维度比较:
- 共享虚拟主机 + 应用层优化:弱隔离(面板配额),月成本 20-80 元,适合 3 个以下低流量站,复杂度低。
- 单台 VPS + 独立 FPM pool:进程级中等隔离,月成本 60-200 元,适合 3-8 个中等流量站。
- 多台 VPS 按站拆分:主机级强隔离,月成本 200-600 元,适合高流量主站加若干小站。
- 容器化(Docker 每站一容器):cgroup 配额硬隔离,月成本 150-400 元,适合技术栈差异大的场景。
两个选择原则:其一,主站峰值超过整台主机容量 50% 时,拆分比调优更划算——2026 年海外 VPS 已低到 8-10 美元/月一档(价格截至 2026 年 10 月,以官网实时报价为准),选型可参考 2026 年海外服务器租赁对比。其二,技术栈不一致时优先上容器做硬隔离;机型怎么选可看 云服务器(由集群虚拟出的弹性主机)选型对比。
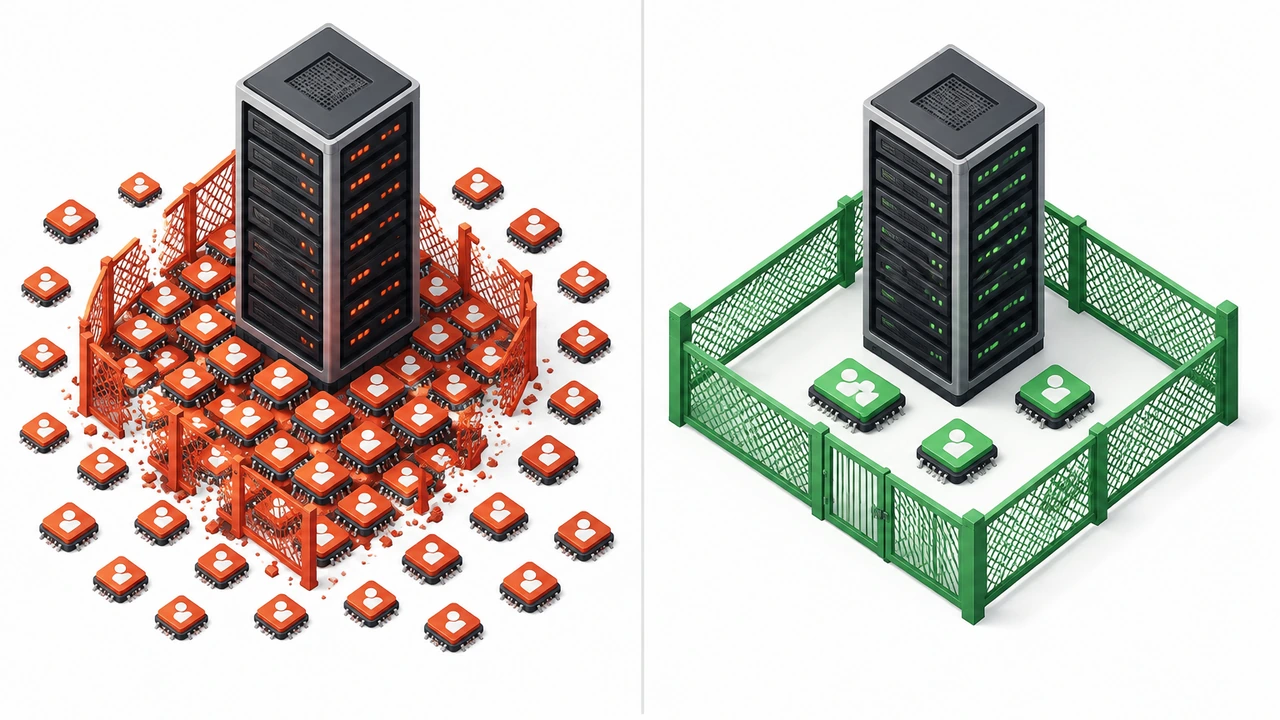
对多数站长而言,”单台 VPS + 独立 FPM pool + CDN”性价比最高:4 核 8G 的 VPS 扛 5 个日 IP 总量 5 万以内的站点没有压力,月成本可控制在 150 元内。
五、日常巡检:把隔离状态变成可量化的指标
隔离不是配置完就结束,缺少巡检的方案会在三个月后悄悄失效。建议每周固定检查三项。
第一是每站内存:用 ps 按用户汇总内存,任何一站超过总内存 35% 就要预警。第二是 CPU steal 基线:vmstat 里 us+sy 常态应在 70% 以下、st 低于 5%,超出就要扩容或找商家理论,命令拆解见 VPS 实用 CPU steal 与 I/O 排查教程。第三是峰值水位:按小时聚合 Nginx 日志,连续两周涨幅超 30% 就是拆分信号。
把这三项做成每周 cron 输出的邮件,5 分钟就能看完。巡检记录也是与商家沟通的证据,st 持续偏高时把采样发给客服,比一句”服务器很卡”有效。
六、总结与行动建议
多站点共用主机的资源隔离,本质是”把不确定的邻居风险变成确定的配额”:先确认边界,再钉死进程数,然后以 CDN、限流、队列化三道防线应对峰值,最后靠每周巡检维持有效性。
如果你正准备把多个站点迁到同一台主机,建议按这个顺序操作:先建独立的运行用户和 FPM pool,再接入 CDN 并压测并发上限,最后补上每周巡检脚本。如果你需要现成的高性价比主机,Hostease 的虚拟主机套餐支持多站点部署并提供中文工单支持,可作为起步选择。一般来说,宁可每周多看一眼数据,也不要等邻居站点把主机拖垮后才想起补课。