
“我的服务器是不是被丢包了?”这是主机论坛里最常见的问题之一。用户反馈 SSH 卡顿、网站间歇性打不开,但 ping 服务器 IP 时好时坏,说不清问题出在自己、机房还是运营商。本文教你如何用 mtr 和 traceroute 两个工具做完整的网络链路诊断(network path diagnosis,逐跳检查数据包从本机到目标服务器之间每一站状态的方法),用实测数据回答三个关键问题:丢包发生在哪一跳、延迟在哪一段飙升、责任在谁。掌握这套方法后,你向机房提交工单时能附上无法反驳的证据,而不是一句”感觉变慢了”。
两个工具的分工:traceroute 看路径,mtr 看统计
traceroute(路由追踪工具)和 mtr(my traceroute,融合 ping 与 traceroute 的诊断工具)经常被混为一谈,但它们的分工其实很清楚。traceroute 回答”数据包经过哪些节点到达服务器”,它给每一跳发三次探测包,输出单次快照;mtr 回答”每一跳的丢包率和延迟分布”,它会持续对每一跳发送大量探测并汇总统计。排查丢包问题时,mtr 的统计价值远高于 traceroute 的单次快照——丢包往往是间歇性的,跑一次 mtr 收集几十秒数据,比连续跑十次 traceroute 更有说服力。
两个工具的安装都很简单。CentOS/AlmaLinux 执行 yum install -y mtr traceroute,Ubuntu/Debian 执行 apt install -y mtr-tiny traceroute。mtr 有交互界面和文本报告两种模式:直接运行 mtr 1.2.3.4 进入实时刷新界面,按 q 退出;排查取证时用报告模式,在你的本地终端执行:
mtr -rwc 100 1.2.3.4
参数含义:-r 输出报告、-w 使用宽格式、-c 100 发送 100 个探测包。100 个包大约耗时 100 秒,样本量足够让间歇性丢包现形。下面以测试 IP 203.0.113.10 为例:
mtr -rwc 100 203.0.113.10
实测案例:一段真实链路报告怎么读
下面是一次从本地到海外服务器的真实 mtr 报告节选(IP 已做脱敏处理):
HOST: local-pc        Loss%   Snt   Avg  Best  Wrst StDev
  1. 192.168.1.1       0.0%   100   1.2   0.8   9.1   0.9
  2. 10.22.33.44       0.0%   100   3.5   2.9  15.2   1.8
  3. 59.43.xx.xx      92.0%   100   4.1   3.7   6.3   0.5
  4. 59.43.xx.yy       0.0%   100  28.4  27.9  31.2   0.7
  5. 218.30.xx.xx      0.0%   100  150.8 149.5 156.1  1.4
  6. 203.0.113.10      0.0%   100  152.3 150.8 158.9  1.6
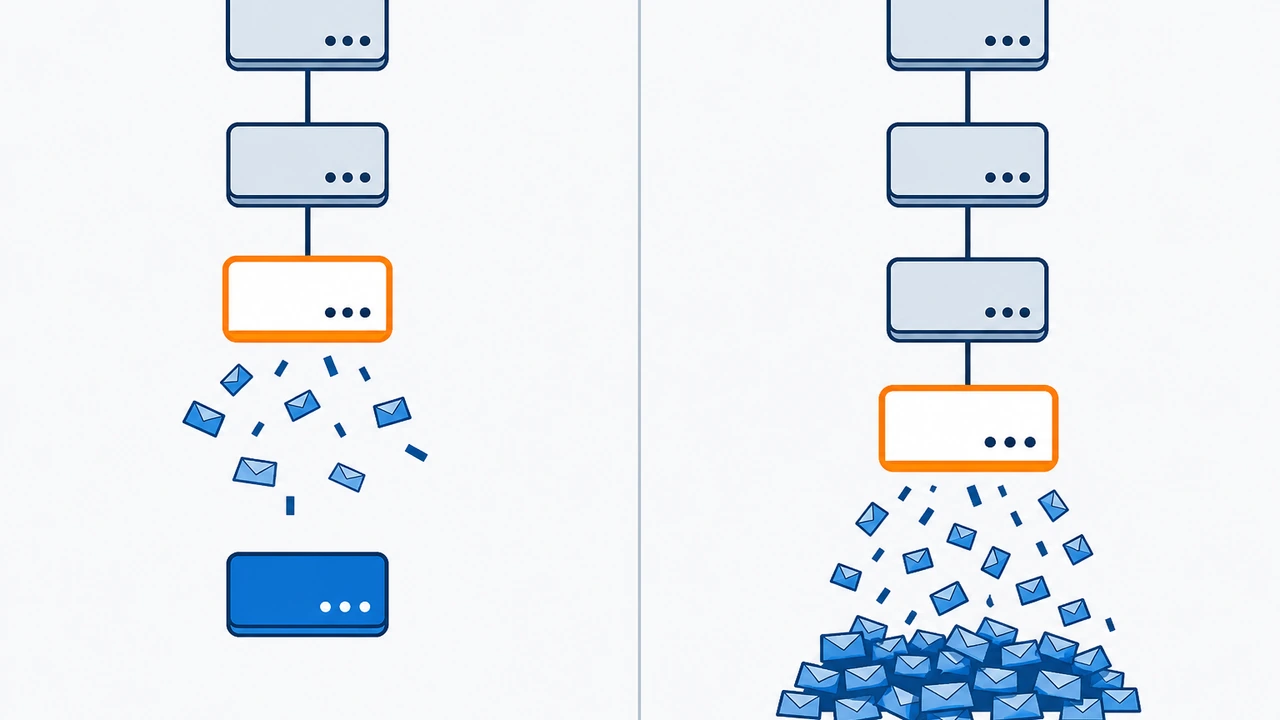
读这份报告的关键是”末端原则”:只有目标服务器或接近目标的跳数出现持续丢包,才能判定链路真的有问题。第 3 跳显示 92% 丢包,但第 4 跳以后全部正常——这是典型的中间节点限速探测包(ICMP 降级处理)造成的假丢包,不影响真实业务流量,不需要处理。真正要警惕的是两种形态:一是目标行本身丢包率超过 3%,二是从某一跳开始丢包出现并延续到终点。这份报告里真正的异常是第 5 跳延迟从 28ms 跳到 150ms,说明跨境出口段拥堵,这个结论比纠结第 3 跳的假丢包有价值得多。
还有一条规则能帮你识别假象:如果某一跳丢包率高、但它的下一跳丢包率回落,且目标不丢包,问题就不成立。运营商对中间节点 ICMP 包限速非常普遍,初学者最常犯的错误就是把这类节点报告为”故障点”,写进工单只会浪费双方时间。
双向测试与责任判定:把问题定位到具体一侧
单方向的 mtr 只能证明”去程”有问题,而链路故障经常只影响单方向。完整取证需要在服务器上反向跑一次 mtr 指向本地 IP,两端各跑 100 包,对比两份报告。去程丢包、回程正常,问题在去程方向的运营商链路;两端都正常但用户体验差,问题可能在用户的最后一公里接入网。双向报告放在一起,责任边界一目了然——这也是资深运维提交工单的标准姿势。
判定责任归属有一条实用的跳数分界法。mtr 报告的前 1-3 跳通常是你本地的接入网,中间 3-8 跳是骨干运营商,最后几跳进入机房内网。丢包或延迟飙升落在哪个区间,责任就归哪一侧:出机房前就丢包,找你的运营商;进了机房内网才丢包,找主机商。以常见的美国服务器场景为例,如果中国电信骨干段(59.43 开头的节点)出现持续 15% 以上的丢包且延续到终点,这就是运营商国际出口拥堵,换机房解决不了,换 CN2 GIA 一类的优化线路才有意义,具体线路实测方法可以参考美国服务器中国访问 CN2 线路实测。
定位清楚之后,处理方式取决于结论。机房内网问题:把双向 mtr 报告附进工单,要求机房检查交换机端口或更换 IP。运营商出口拥堵:避开高峰时段观察,或者迁移到优化线路。用户侧问题:让用户跑一条 mtr -rwc 50 服务器IP 截图回传,多数是本地 Wi-Fi 或运营商接入网波动。如果排查下来是服务器本身的带宽(单位时间内链路能传输的数据量)或线路规格不足,选型时可以参考美国 VPS(虚拟专用服务器,把一台物理服务器划分成多个独立运行环境的方案)速度影响因素与优化,把线路质量作为第一优先级。
高峰期对比测试与总结建议
丢包和延迟问题有明显的时间属性:国际出口在工作日晚高峰(20:00-23:00)最拥堵,凌晨则基本畅通。建议做一组对比测试——高峰期和平峰期各跑一次 mtr -rwc 100,两次报告的差异会直接告诉你问题是固定容量不足还是时段性拥堵。固定丢包(任何时段都出现且位置不变)指向硬件或线路故障,需要机房介入;时段性劣化指向出口带宽争抢,需要换线路或换机房。
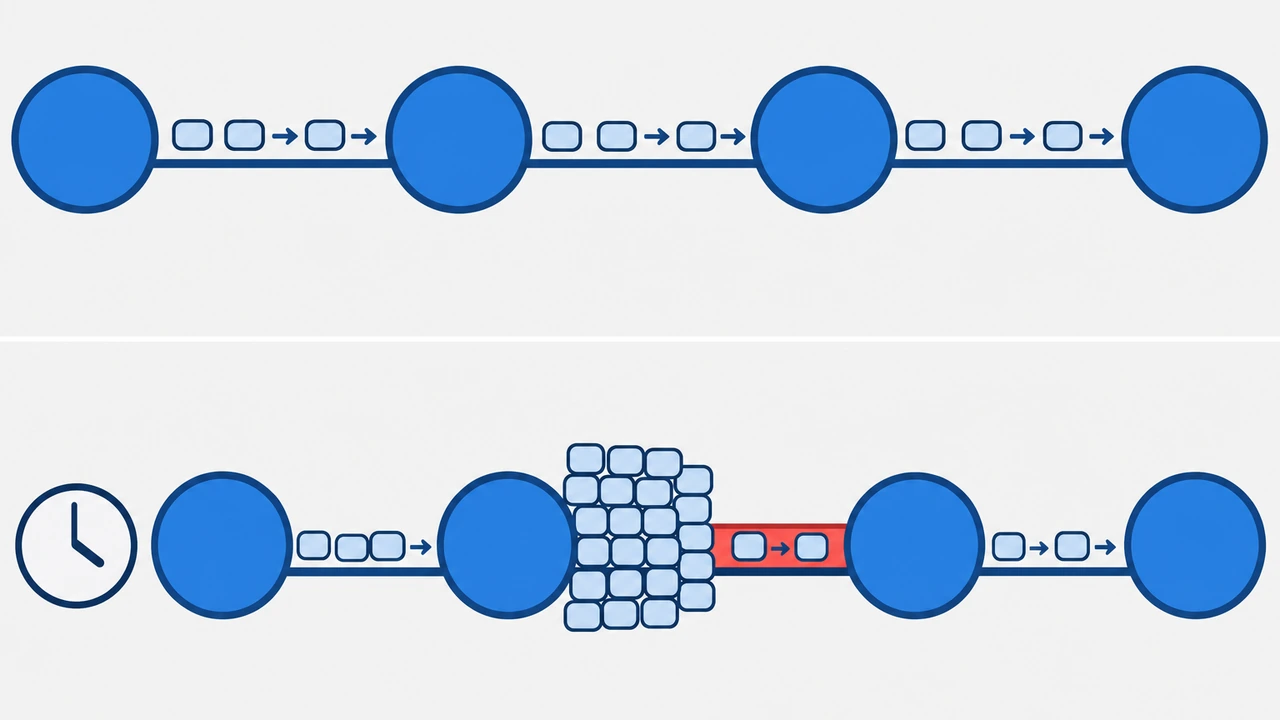
总结这套网络链路诊断流程:先用 mtr -rwc 100 拿到统计报告,用末端原则排除中间跳假丢包,再反向测试划清责任边界,最后按时段对比确定拥堵性质。这套方法的价值在于把”感觉变慢了”变成有数据、有方向、有责任方的证据链。我们在处理 Hostease 用户工单时也沿用同样的流程:用户附上一份双向 mtr 报告,多数情况下十分钟内就能判定是机房内网还是国际出口的问题,省去了来回扯皮的时间。
给你的建议是:现在就在你的服务器上装好 mtr,分别对你的常用访问端和几个大城市的 ping 目标各跑一次基线报告存档——出了问题时拿新报告和基线一对比,变化点立刻现形。选购新服务器时,也建议先向主机商要一个测试 IP 跑 24 小时 mtr 观察丢包率再付款,这个习惯能帮你避开大量售后纠纷。如果你正在评估不同地区的服务器,香港服务器选购六大指标一文中的网络评估维度可以作为配套参考。