
TL;DR:如何在 VPS 上把 SSH 爆破挡在登录之前
一台刚上线的公网机器,通常几个小时内就会被扫描器记下地址,随后是每天数千次的密码尝试。等到登录日志里出现陌生的成功记录,再回头看备份和权限配置就已经晚了。本文把 fail2ban 的落地拆成四段:日志从哪读、参数怎么定、白名单怎么留退路、封禁之后怎么确认真的生效。
- 默认 22 端口的机器,每天遭遇的失败登录通常在数千次量级,单地址连错 5 次封 10 分钟,能筛掉大部分广撒网扫描。
- fail2ban 只在用户态读日志、匹配正则、调防火墙,不装内核模块,也不改 sshd 本身。
- 白名单必须写在封禁规则之前,并覆盖固定出口地址与内网段,否则一次手滑就把自己关在门外。
- 只改 jail.local,不动 jail.conf;发行版升级会覆盖后者,写在里面的规则会静默消失。
- 封禁是否生效要看 fail2ban 状态与防火墙链两处,日志里出现 found 只说明匹配成功。
为什么 SSH 爆破值得单独处理
很多人的第一反应是改默认端口、禁用密码登录,这两条确实有效,但它们改变的是暴露面,不是行为模式。扫描器会跟着开放端口走,而一旦为了自动化脚本保留了密码登录,爆破就重新有了入口。SSH 的特殊性在于它是整台机器的总开关,一次成功登录等于拿到系统级权限。
我在一台 2 核 2GB、洛杉矶节点的测试机上连续看了 7 天的 /var/log/auth.log:平均每天 4200 条失败记录,来源集中在三个固定的网段,被尝试的用户名几乎全是 root、admin、ubuntu 这类默认值。换成五位非标端口后,失败记录降到每天 300 条左右;但端口一旦被扫出来,频率两天内就会回到原来的水平。
这也是 fail2ban 仍然值得部署的理由:它不指望攻击者不来,而是把「猜错」的成本抬到不值得继续。配合密钥登录与禁用 root 直登,多数自动化尝试会停在认证环节之外。
fail2ban 的判定链路:从日志行到防火墙规则
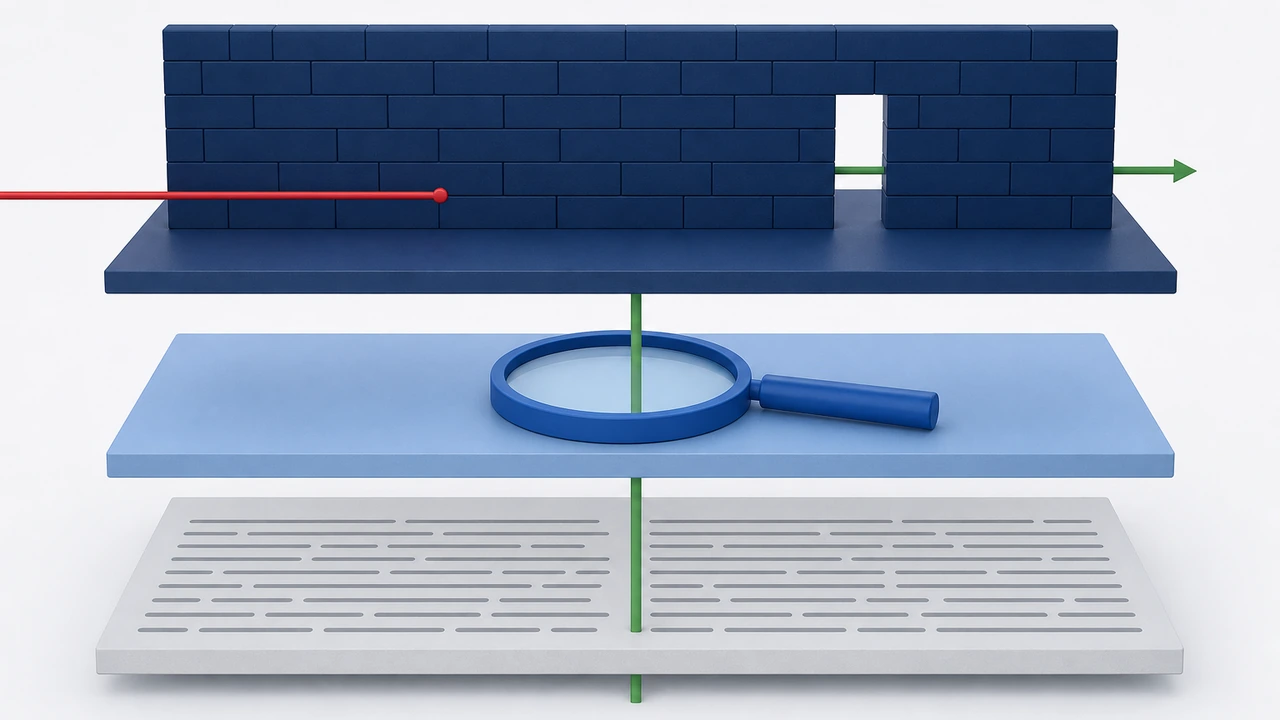
在一台 VPS(虚拟专用服务器)上,fail2ban 本身不做任何拦截,它只做三件事:持续读日志、用正则匹配失败记录、按阈值调用防火墙动作。理解这条链路,后面的排错会快很多。filter 负责定义什么算失败,例如 sshd 的 Failed password 与 Invalid user;jail 把 filter 和阈值参数绑在一起,并指定作用于哪个防火墙;action 才是真正写规则的那一步,较新的系统默认走 nftables,老系统仍是 iptables。
日志来源是第一个容易踩空的地方。Ubuntu 22.04 之后 sshd 默认写 journald,只有在装了 rsyslog 时才会同时落到 /var/log/auth.log。先确认日志实际写到哪里,再决定 jail 里的 backend 与 logpath:看最近记录用 journalctl -u ssh -n 20,看文件是否存在用 ls -l /var/log/auth.log。
链路理清之后规则才有意义。常见的错误是跳过这一步直接抄配置,backend 指向一个并不存在的日志文件,服务照常启动、状态也正常,但计数一直是 0。论坛的 技术教程区 里这类排查记录不少,多数都归结为日志路径与后端不匹配。
安装与最小可用配置
apt update
apt install -y fail2ban
systemctl enable --now fail2ban
fail2ban-client status
装完先别急着改规则。发行版自带的 jail.conf 会在每次升级时被覆盖,写在那里的改动会静默消失,所以本机配置统一放到 jail.local,jail.conf 只当只读参考。下面这份配置假设日志走 journald、SSH 仍监听 22 端口,属于能跑起来的最小集合。
jail.local:白名单放在规则前面
[DEFAULT]
ignoreip = 127.0.0.1/8 ::1 203.0.113.24
backend = systemd
bantime = 1h
findtime = 10m
maxretry = 5

[sshd]
enabled = true
port = 22
maxretry = 3
bantime = 24h
三个参数的关系用一句话就能记住:在 findtime 这段时间内,同一个地址累计失败到 maxretry 次,就封 bantime 那么久。ignoreip 写在 [DEFAULT] 段,意味着所有 jail 都继承这份白名单,这是刻意安排的顺序:先声明谁不被封,再谈封谁。
参数怎么定:三档配置对照
| 用途 | maxretry | findtime | bantime |
|---|---|---|---|
| 个人博客或测试机 | 5 | 10 分钟 | 1 小时 |
| 有固定办公出口的小团队 | 3 | 10 分钟 | 24 小时 |
| 对外提供 SSH 或跳板用途 | 3 | 5 分钟 | 7 天,配合 recidive |
三档之间的差别不在严格程度,而在误伤成本。maxretry 定成 3 时,手机热点下重连几次输错密码就会被封,出差途中很难自己解开;定成 5 更宽容,但也等于给攻击者留了五次机会。稳妥做法是先按 1 小时封禁跑一周,看状态里的 Total banned 与误封记录,再决定是否收紧。
对反复来访的地址,recidive 值得加上:它监控 fail2ban 自己的封禁日志,同一地址被反复封禁就拉长到周级,比单纯调长 bantime 更有针对性。选机器时若更看重线路稳定性,可先对照 VPS 主机排名 里的实测数据,机房位置对 SSH 交互体验影响明显。
白名单的三个细节
第一,别只写单个地址:家庭宽带与办公出口多是动态地址,光猫重启就换一个,写死 /32 等于没写,按网段写 /24 更实用。第二,白名单要覆盖内网段与跳板机,否则监控心跳会被算成异常连接。第三,改完用 reload 重载而不是重启,重载不清空已有封禁记录,重启会让正在被封的地址提前解封。
fail2ban-client set sshd addignoreip 203.0.113.0/24
fail2ban-client set sshd unbanip 203.0.113.24
fail2ban-client reload
如果已经把自己关在门外,别急着重装系统。通过控制台的 VNC 或服务商的救援模式进入,执行 unbanip 指定自己的地址即可恢复;实在进不去,删掉防火墙里 f2b-sshd 链上的那条规则也能立刻解开。改规则时留一个已登录会话别退出,用另一个窗口测试,即使写错,手里还有一条活路。
验证:三个层面都要对得上
fail2ban-client status sshd
fail2ban-client get sshd banip
iptables -L f2b-sshd -n --line-numbers
status 里的 Currently banned 是 fail2ban 自己的计数,banip 列出被封地址,防火墙链才是实际生效的规则。三者对不上是常见现象:状态显示已封但链里为空,多半是 backend 与日志路径不一致,读到了记录却没有可执行的动作;反过来链里有规则而状态为空,通常是重载之后旧规则残留,重启服务才能清干净。
测试时不要用自己正在使用的地址。找一台独立出口的机器,故意输错密码三次,立刻查状态与链规则,再确认该地址发起的新连接是否超时。把检查写进巡检脚本,改完规则跑一遍。
四个容易翻车的点
- backend 写 auto 但系统没装 rsyslog:fail2ban 找不到日志文件,服务启动正常、计数始终为 0,用 journalctl -u ssh -n 5 先确认日志落在哪。
- 改了 SSH 端口却没改 jail 里的 port:链名仍是 f2b-sshd,但匹配的端口不对,封禁对象和真实连接错位。
- Docker 主机上直接套用默认配置:容器流量走 DOCKER 链,fail2ban 写的规则排在前面也不会命中,需要在转发链尾部单独加一条规则。
- 忽略日志轮转:auth.log 被切走后句柄没重开,计数停摆,检查 logtarget 与轮转配置,或干脆改用 systemd 后端。
这四条里有三条不会报错,只会让封禁静默失效。判断方法很朴素:连续看两天 Total banned,一直是 0 而日志里明明有成百上千条失败记录,那就是链路断了,与规则严不严无关。
总结:上线前确认这三件事
回到最初的问题,fail2ban 的价值不在于把攻击者全挡住,而在于让自动化爆破在成本上不划算。上线前建议按顺序确认三件事:日志来源与 backend 是否一致、白名单是否覆盖固定出口和内网段、封禁后防火墙链里是否真多出一条规则。这三条对得上,参数调优才有意义。
如果机器上还跑着网站,顺带把 SSH 之外的入口一起收一收:数据库不对公网监听、面板限制来源地址、定期核对登录记录。需要中文工单与本地化支持的话,可以考虑 Hostease 的 VPS 专区 里列出的方案,下单前确认是否提供控制台救援通道,这决定了规则写错时你还有没有第二条路。
推荐先用 1 小时封禁跑一周,记下误封记录与总封禁数,再决定是否收紧阈值。等流程稳定,再叠加密钥登录、recidive 和登录告警,一层层加,比一次性上全套更容易定位问题。