
为什么美国VPS(虚拟专用服务器)上线后的故障最容易被误判?因为很多问题看起来都像“服务器不稳定”:网页打不开、SSH(安全外壳远程登录协议)卡住、数据库连接超时、晚高峰延迟飙升。真正有效的办法不是立刻重装系统,而是用固定顺序把网络、系统、Web服务和数据层逐层拆开验证。本文给出一套可直接照着执行的排障指南,帮助你在10到30分钟内判断故障属于本机配置、业务负载,还是跨境线路问题。
先定边界:不要一上来就怀疑服务商
上线后的第一类误判,是把所有现象都归因于“VPS(虚拟专用服务器)商不稳”。白天正常、晚上打不开,或 SSH(安全外壳远程登录协议)能连但前台 502,根因可能完全不同。
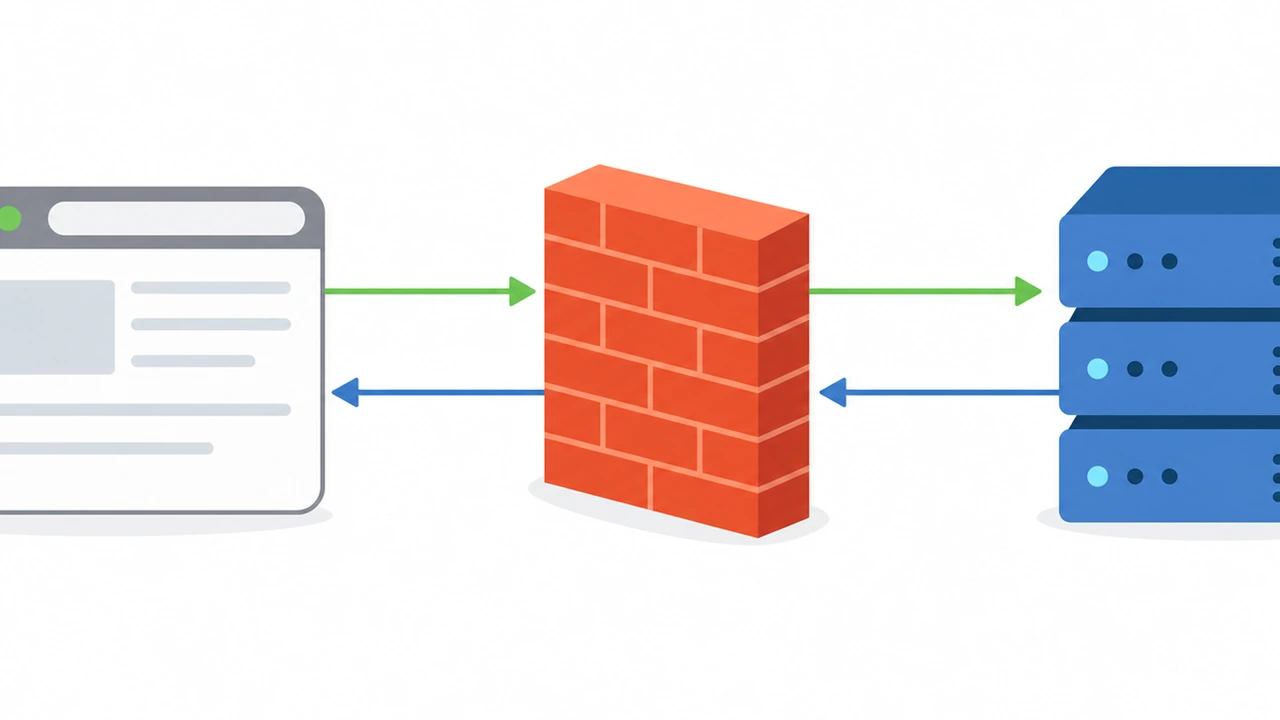
先做三层边界确认:本地客户端是否异常、服务器端口是否可达、应用服务是否真的在监听。比如手机 5G 能打开而办公室宽带打不开,优先查本地网络;SSH(安全外壳远程登录协议)可连而 80/443 不通,优先查防火墙和 Nginx。
这一步看似慢,实际能节省时间。重装系统通常要 20 分钟以上,还会丢掉日志;ss -lntp、curl -I、systemctl status 往往 2 分钟就能缩小范围。
第一步:SSH能不能稳定登录
SSH(安全外壳远程登录协议)是排障入口。只要它稳定可用,后续多数问题都能在服务器内解决。
常用检查顺序如下:
常见误操作是只改 SSH(安全外壳远程登录协议)端口,却忘了同步放行防火墙。处理端口变更时,先开新终端验证新端口,再关闭旧会话。
如果你还在选型阶段,可以先看 更多VPS选型参考。那篇更偏购买前判断,本文只讨论买完以后如何定位线上故障。
第二步:确认Web端口和Nginx状态
SSH(安全外壳远程登录协议)正常以后,下一步不要先打开浏览器刷新十几次,而是直接检查端口和服务。浏览器只告诉你“打不开”,服务器命令才能告诉你卡在第几层。
先在服务器本机执行 curl -I http://127.0.0.1。如果本机返回 200 或 301,但公网访问失败,优先查防火墙、安全组、域名解析和 CDN(内容分发网络);如果本机也失败,再用 nginx -t、systemctl status nginx --no-pager 和 tail -n 80 /var/log/nginx/error.log 查服务状态。
502 通常表示上游进程不可用,比如 PHP-FPM socket 路径写错或反向代理端口填错;504 更像上游响应太慢,比如数据库慢查询或外部 API 超时。二者都不是“服务器宕机”的直接证据。
简单判断:如果 /robots.txt 能秒开,而 WordPress 首页慢到 10 秒以上,Nginx 多半正常,问题更可能在 PHP、数据库或插件层。迁移后异常可参考 WordPress网站高效迁移指南。
第三步:数据库和磁盘要一起看
很多“数据库挂了”的故障,真实根因是磁盘满、inode(文件索引节点)耗尽或内存不足。MySQL/MariaDB 无法写入临时文件时,前台会表现为连接失败、后台加载慢,甚至间歇性 500。
先跑三条命令:df -h 看容量,df -i 看 inode(文件索引节点),free -m 看内存。根分区超过 90% 先清日志和备份包;内存长期低于 200MB,就要查数据库和 PHP-FPM。
数据库不要只看 systemctl status mysql。SHOW PROCESSLIST; 里大量 Sleep 连接可能是应用未释放连接;大量 Query 卡在同一张表,优先查慢 SQL 或锁表。2核4G 的美国VPS(虚拟专用服务器)不建议把 max_connections 无脑拉到 1000。
磁盘清理别只删当前目录。journalctl --disk-usage 看系统日志,du -h --max-depth=1 /var/log 找日志大户,清理后配合 logrotate,避免一周后复发。
第四步:线路问题要用MTR分段判断
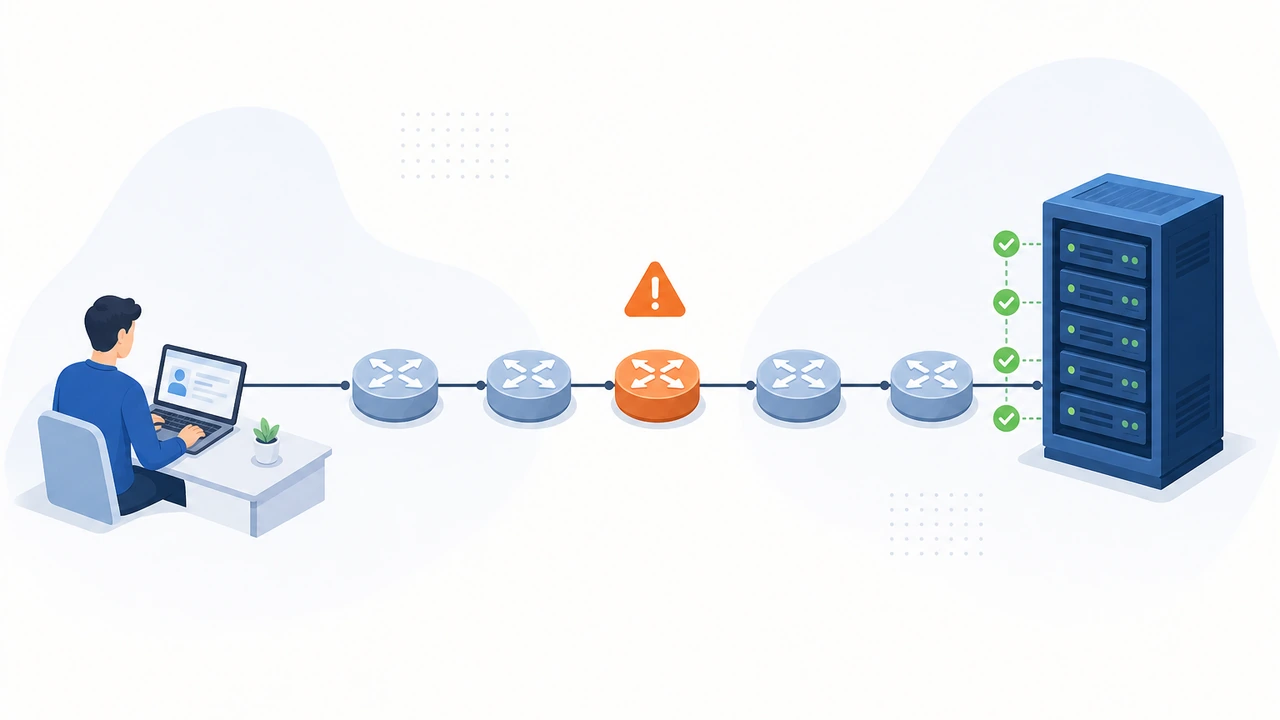
跨境访问美国VPS(虚拟专用服务器)时,线路问题确实存在,但不能只凭“我这里 ping 高”下结论。正确做法是用 MTR(持续路由追踪工具)分段判断丢包发生在哪一段。
如果丢包只出现在中间节点,但后续节点恢复正常,多半是 ICMP(互联网控制报文协议)限速;如果最后一跳持续丢包,才更接近真实链路问题。晚高峰建议在 20:00 到 23:00 跑 100 到 200 包。
常见线路表现可以粗略这样看:CN2 GIA 回程在大陆方向通常更稳,晚高峰延迟波动较小;普通 163 线路在拥堵时可能出现 200ms 以上抖动和明显丢包;BGP(边界网关协议)线路要看具体回程策略,不能只看商家页面写了“多线”。关于 BGP(边界网关协议)在国内高峰期的表现,论坛里已有一篇 BGP线路在国内的真实表现,建议和自己的 MTR(持续路由追踪工具)结果对照看。
如果你的主要用户在中国大陆,线路选择本身就会影响后续排障成本。以 Hostease 的美国 CN2 GIA 方案为例,它适合把稳定访问放在优先级前面的站点;但即便使用优化线路,也建议保留 MTR(持续路由追踪工具)截图和故障时间点,方便后续和工单沟通。
第五步:把故障记录成可复用runbook
一次故障处理完,不记录就等于只解决了一半。美国VPS(虚拟专用服务器)上线后的问题往往会重复出现:证书续期失败、日志打满、PHP-FPM 子进程耗尽、数据库慢查询、晚高峰路由抖动。把排查顺序写成 runbook,下一次就不用靠记忆临场发挥。
一个实用模板包括 6 项:故障时间、影响范围、第一现象、执行过的命令、最终根因、预防动作。例如“21:15 首页 504;error.log 显示 upstream timed out;处理方式是加索引并恢复 PHP 超时阈值”。
监控阈值也要写进 runbook。磁盘超过 85%、内存低于 300MB、Nginx 5xx 比例超过 2%、SSL(安全传输协议)证书到期前 15 天,都应触发提醒。
如果没有成熟监控,至少用 crontab 每 5 分钟请求一次首页,并把非 200/301 状态写入日志,先解决“挂了半天没人知道”的问题。
什么时候该升级配置或换线路
排障的最后一步,是判断问题能不能靠配置修复。不是所有故障都值得继续调参。如果 CPU 连续 7 天平均超过 70%,内存峰值每天触顶,数据库慢查询优化后仍然扛不住业务量,就该升级配置;如果 MTR(持续路由追踪工具)连续多日晚高峰最后一跳丢包超过 5%,而业务主要面向国内用户,就该考虑换到更适合的回程线路。
也不要只看价格。测试站可以用便宜方案,商业站点更应关注线路稳定性、快照备份、工单响应和故障透明度。Hostease 这类提供中文工单和付款便利的服务商,适合希望降低沟通成本的团队,但最终仍应以自己的访问数据为准。
总结
美国VPS(虚拟专用服务器)上线后的排障建议按固定顺序推进:先确认 SSH(安全外壳远程登录协议)和端口,再查 Nginx 与应用服务,然后看数据库、磁盘和内存,最后用 MTR(持续路由追踪工具)判断跨境线路。这样做的好处是每一步都有证据,能减少误判。
如果你需要一份最小行动清单,可以从今天开始做三件事:保存本文这套排查顺序;给磁盘、内存、5xx 和 SSL(安全传输协议)证书加上监控;每次故障结束后写一条 runbook 记录。排障能力不是靠重装系统练出来的,而是靠稳定的检查顺序和可复用的证据链积累出来的。