论坛上讲 RAID 跑分的帖子已经不少,但真正让站长们夜里睡不着的不是跑分,而是坏盘之后的那段时间:阵列还在降级运行,重建正在进行,业务还在写入,第二块盘会不会跟着倒下?这篇不重复那些顺序读写天梯榜,专讲坏盘之后的重建窗口(rebuild window,即从换盘到数据完全同步的这段时间):RAID1、RAID5、RAID10 各要重建多久、重建期间业务性能掉多少、坏第二块盘的后果分别是什么,帮你解决”降级期间该不该顶住”和”下单时该选哪种阵列”两个问题。
测试环境:4 块 480GB SATA SSD,LSI 9361-8i 硬 RAID 卡(1GB 缓存),Xeon E5-2680 v4,32GB 内存,Debian 12,XFS 文件系统。每次测试都重建阵列、重新格式化,用 fio(Flexible I/O Tester,Linux 标准磁盘压测工具)在重建期间持续施加 4K 随机写负载,模拟真实业务压力。
测试方法:人为拔盘触发重建
先说清楚操作步骤,你可以直接照做验证。对每种阵列等级执行同一套流程:
- 建阵列、格式化、预热写入约 300GB 数据,保证盘不是空盘状态
- 启动后台负载:fio –name=load –rw=randwrite –bs=4k –iodepth=32 –direct=1 –runtime=1800
- 运行中直接拔掉一块成员盘,记录 RAID 卡进入降级状态的时间
- 插回一块同型号干净盘,计时到阵列恢复正常冗余
- 对比重建前、重建中、重建后的 IOPS 三个数值
重建期间的性能衰减取重建进行到 50% 时的 IOPS 读数,这样能避开刚启动时的缓存干扰。每种阵列完整跑两轮,取平均值。
重建耗时:三种阵列差距比想象中大
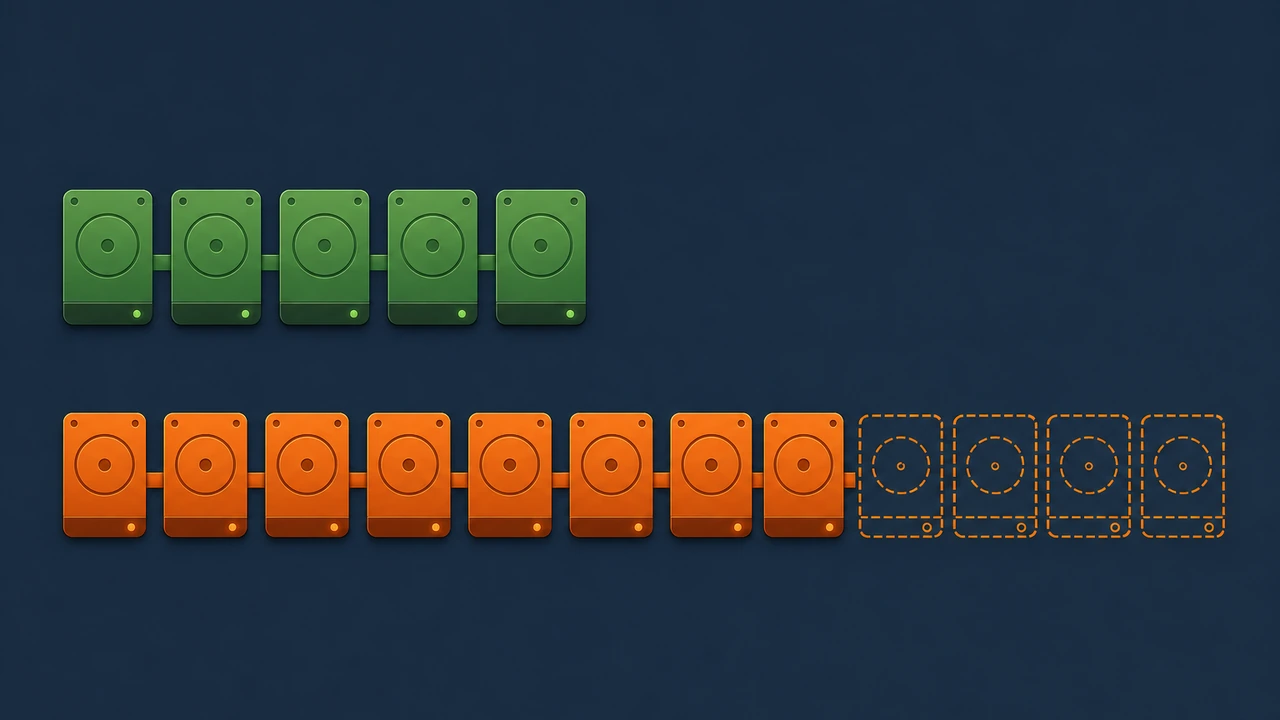
先给结论性数据:RAID1 和 RAID10 的重建耗时基本一致,约 25 分钟;RAID5 需要 55 分钟,正好是前两者的两倍出头。原因在机制上:镜像阵列重建只是把幸存盘的数据原样复制到新盘,一次顺序读配一次顺序写就完事;RAID5 重建要靠剩余成员盘的条带和校验信息逐块算出丢失的数据,校验运算本身就拖慢了整个过程。
480GB SSD 55 分钟听起来还能忍,但把盘换成 8TB SATA 机械盘,情况立刻恶化:顺序复制型的镜像重建大约拉长到 6-8 小时,而 RAID5 的校验重建会超过 20 小时,期间整台机器还要顶着业务负载。重建窗口越长,同批次、同盘龄的第二块盘在这个窗口里倒下的概率就越高——这是 RAID5 在大容量机械盘阵列上口碑持续下滑的核心原因。
重建期间的业务衰减:降级运行的真实代价
坏盘之后、重建完成之前,阵列处于降级状态,业务性能的衰减实测如下:
- RAID1:4K 随机写从约 37,000 IOPS 降到 30,500,衰减约 18%
- RAID5:从约 28,000 IOPS 降到 16,800,衰减约 40%,重建过半时最为明显
- RAID10:从约 71,000 IOPS 降到 60,300,衰减约 15%,四种等级里最稳
RAID5 重建期间最难受的地方在于”双倍惩罚”:RAID 卡既要腾出算力做校验重建,又要处理新写入带来的额外读旧数据、读旧校验、写新校验开销。如果你的业务高峰恰好撞上重建窗口,用户侧的卡顿会非常直观。这种时候可以考虑限速重建(多数 RAID 卡支持 rebuild rate 设置,调到 30% 左右),用更长的重建时间换业务可用性。
二次坏盘:重建窗口里的生死线
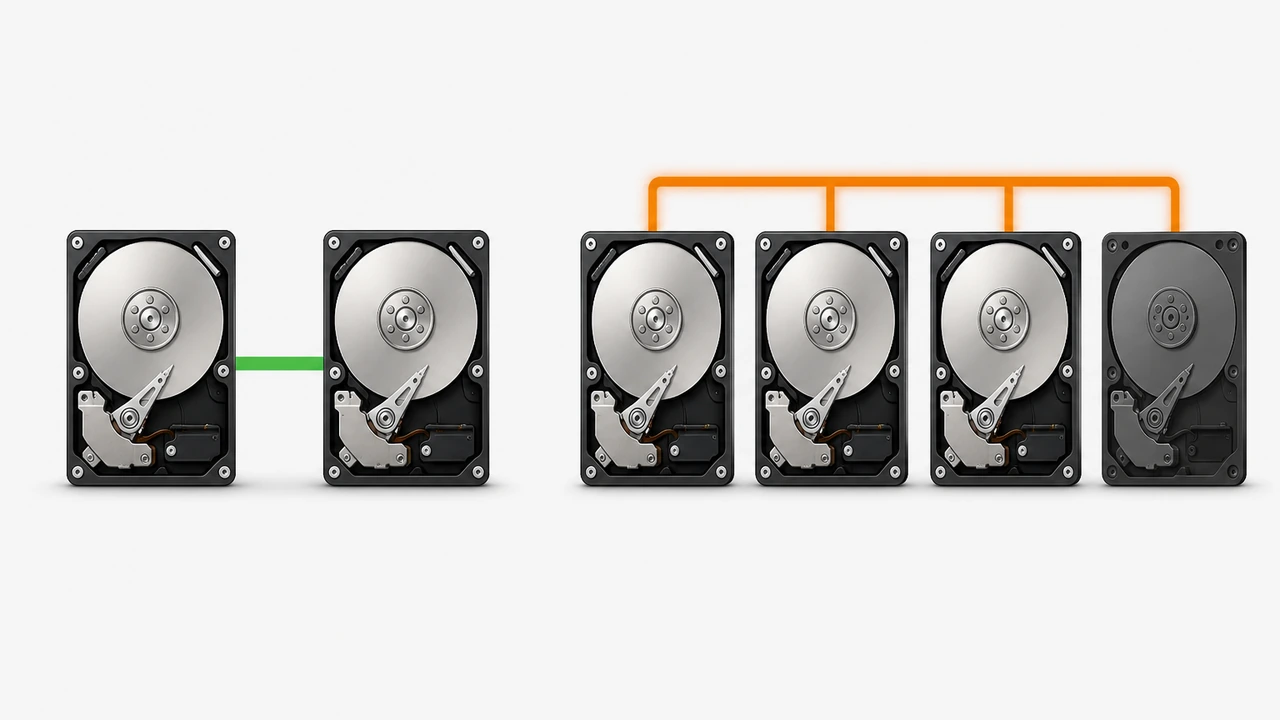
重建窗口里最坏的情况是第二块盘也坏了,三种阵列的结局完全不同:
- RAID1 降级后坏第二块盘:数据全丢,但两块盘同时坏的窗口只有 25 分钟
- RAID5 降级后坏第二块盘:数据全丢,且这个高危窗口长达 55 分钟甚至 20 小时(机械盘)
- RAID10 降级后坏第二块盘:只要倒下的不是同一个镜像对里的另一块,数据无损,继续降级运行
这就是社区老鸟常说的”RAID10 的容错不是 50% 存活率,而是不能碰巧坏一对”。四个成员盘的 RAID10 有六种双盘故障组合,其中四种不丢数据,概率上占优;而且镜像对的重建压力小、窗口短,进一步压低了撞上二次坏盘的机会。
下单之前:三条可执行的决策建议
把实测数据翻译成选购动作,建议按这个顺序过一遍:
- 机械盘阵列、单盘 4TB 以上:直接排除 RAID5,预算够上 RAID10,盘位不够上 RAID6
- SSD 阵列、数据库或高并发虚拟主机:RAID10 是默认答案,重建快、衰减低、容错逻辑清晰
- 到手机器后先用 mdadm 或 RAID 卡管理界面确认当前阵列等级和重建策略,别默认商家给你配好了
选阵列等级和选机型是绑在一起的。如果你还在对比各家独服(独立服务器的社区简称)的价格与配置,可以参考这篇国外独立服务器价格与品牌分析;香港机型的配置选择细节,这份独立服务器租用指南讲得比较全。下单 Hostease 这类支持自选阵列等级的独服商家时,建议直接在配置页指定 RAID10 并加一块热备盘,比事后自己重建阵列省心得多。
如果机器已经在线运行,建议现在就把 rebuild rate 和热备盘(hot spare,插在阵列里随时待命的备用盘)策略检查一遍——坏盘不挑时间,自动重建比人工发现再换盘快得多,窗口越短越安全。
总结
RAID 等级的选型本质上是在买”重建窗口的长度”。镜像类阵列用多一块盘的预算,换来一半的重建时间和 15% 左右的业务衰减;RAID5 省下的盘位成本,会在某个深夜坏盘时以 20 小时高危窗口的形式还回来。如果你还需要结合美国机房的整体租用行情做决策,可以再看看这份美国独立服务器租用排行。建议每个独服(独立服务器的社区简称)用户都在到手当天跑一次本文的拔盘演练(记得先备份),知道自己的阵列坏盘后是什么表现,比看十篇跑分帖都有用。