
网站变慢,先别急着升级配置——瓶颈未必在硬件。实际运维里,大量性能问题来自少数几条执行缓慢的 SQL 语句,MySQL 慢查询日志(Slow Query Log)就是揪出它们的工具。这篇文章会解决两个问题:虚拟主机这种受限环境下如何开启并读取慢查询日志,以及 VPS(虚拟专用服务器)上如何完成完整的配置和分析。两种环境差异很大,用错方法会白费时间。
为什么慢查询日志是排查性能问题的第一入口
与其凭感觉猜测是带宽(网络传输容量)、CPU 还是内存的问题,不如让 MySQL 自己告诉你哪些语句跑得慢。慢查询日志的原理很直接:执行时间超过阈值的语句会被完整记录,包括执行时间、锁等待、扫描行数和 SQL 文本。
实测参考:日均 5 万 PV(页面浏览量)的 WordPress 站点,开启慢查询日志(阈值 1 秒)跑 24 小时往往只有几十条记录,但消耗的数据库时间占 60% 以上——少数慢语句吃掉大部分资源。
动手前先确认环境类型,两类环境的操作路径完全不同:
- 虚拟主机:共享服务器资源,通常只能通过 cPanel(一种主流主机控制面板)或 phpMyAdmin 查看部分状态,无法直接编辑 my.cnf,日志是否开启取决于主机商
- VPS:拥有 root 或 sudo 权限,可自由修改 MySQL 配置、指定日志路径、调整阈值,分析工具链完整
虚拟主机环境:受限条件下的开启与读取
虚拟主机(多用户共享服务器资源的托管形态)的核心限制是:没有 MySQL 配置文件权限,日志开不开、阈值多少都取决于主机商。第一步是确认现状。
先查询当前配置状态
通过 phpMyAdmin(网页版数据库管理工具)执行以下 SQL 查看日志开关和历史统计:
SHOW VARIABLES LIKE 'slow_query%';
SHOW VARIABLES LIKE 'long_query_time';
SHOW GLOBAL STATUS LIKE 'Slow_queries';
slow_query_log 为 ON 说明日志已开启;Slow_queries 是累计慢查询次数。若主机商已开启,可直接在控制面板日志目录或通过工单索取日志文件。
日志未开启时的替代方案
如果返回 OFF,有三个可行路径:
- 提交工单申请:让主机商开启,并说明用途是性能排查。Hostease 这类对中文用户友好的主机商,通常会配合处理这类请求
- 会话级设置:部分主机允许在 PHP 连接后执行
SET SESSION long_query_time = 1;,但只影响当前会话的诊断,不能生成持久日志 - 应用层兜底:在 WordPress 的
wp-config.php中定义SAVEQUERIES(保存查询调试常量),让$wpdb->queries记录每条语句的执行时间并打印到页面底部。注意它会显著增加内存占用,只在排查时临时开启,查完立刻关掉。
VPS 环境:完整配置与开启流程
VPS 环境按标准流程来。以 MySQL 5.7/8.0 为例,编辑配置文件(/etc/my.cnf 或 /etc/mysql/mysql.conf.d/mysqld.cnf)的 [mysqld] 段:
[mysqld]
slow_query_log = 1
slow_query_log_file = /var/log/mysql/slow.log
long_query_time = 1
log_queries_not_using_indexes = 1
四行配置各管一件事:开启日志开关、指定日志路径(目录需对 mysqld 可写)、设置阈值、记录未走索引的语句——这类语句即使只要 0.5 秒,也是未来的性能隐患。
修改后执行 systemctl restart mysqld 生效。生产环境不想重启可动态修变量热生效:
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
SET GLOBAL slow_query_log_file = '/var/log/mysql/slow.log';
热生效不中断服务但重启后失效,排查完记得同步进 my.cnf。
阈值怎么定
阈值不是越小越好:设成 0.1 秒会让大流量站点的日志爆炸式增长,反而掩盖问题。参考值:起步设 1 秒抓最严重的语句,优化一轮后降到 0.5 秒继续收网,再配合 log_throttle_queries_not_using_indexes(限制每分钟记录的未走索引语句数量)防刷屏。
日志分析:从原始记录到优化动作
日志开启 24 小时后就可以分析了。一条典型记录长这样(建站环境搭建可参考宝塔面板一键部署 WordPress 全攻略):
# Time: 2026-10-21T03:12:45.123456Z
# User@Host: wp_user[wp_user] @ localhost [127.0.0.1]
# Query_time: 3.842116  Lock_time: 0.000123 Rows_sent: 12  Rows_examined: 486392
SELECT * FROM wp_postmeta WHERE meta_value LIKE '%keyword%' ORDER BY post_id;
逐字段解读:Query_time 执行耗时 3.84 秒,远超阈值被记录;Lock_time 几乎为零,不是锁竞争问题;关键在最后两项——返回 12 行却扫描 48.6 万行,是返回行数的 4 万倍,典型的索引失效特征:LIKE '%keyword%' 前置通配符让索引无法使用,全表扫描不可避免。
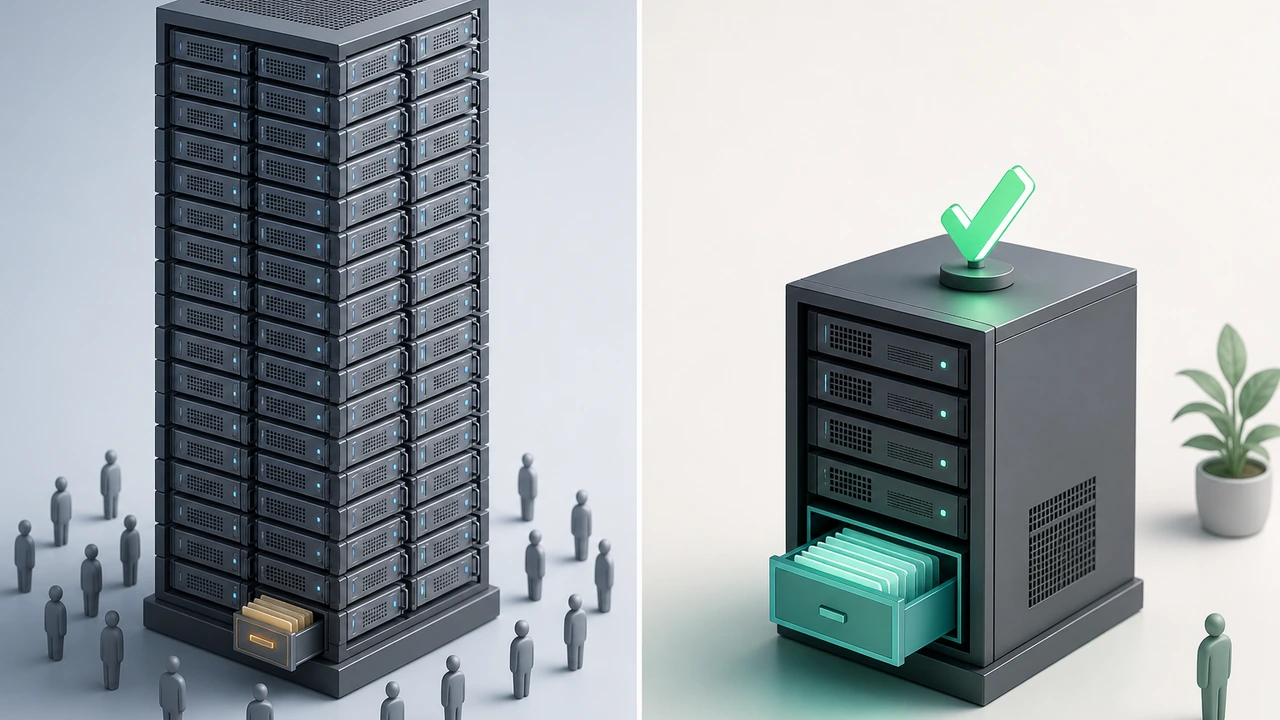
日志量大时逐条读不现实,用官方自带的 mysqldumpslow 聚合分析:
mysqldumpslow -s t -t 5 /var/log/mysql/slow.log
这条命令按总耗时排序输出最慢的 5 条语句模板。-s t 可换成 -s c(按次数)或 -s at(按平均耗时),交叉对比就能锁定优化优先级。VPS 用户还可以用 pt-query-digest(Percona Toolkit 的日志分析工具)看执行分布。
常见优化方向与验证方法
分析出慢语句后,优化通常落在三个方向(按命中率排序):
- 补索引:
Rows_examined远大于Rows_sent时,优先检查 WHERE 和 ORDER BY 涉及的列是否缺索引,用EXPLAIN前后对比扫描行数验证 - 改写语句:避免
LIKE '%xx%'前置通配符、避免在索引列上套函数(如DATE(create_time))、大分页改用游标方式 - 业务层减负:循环里逐条查询改成批量 IN 查询,报表类重查询挪到只读副本或低峰期
每改一条都要有前后数据对比。实测案例:给 wp_postmeta 的 meta_key 列补上联合索引后,3.8 秒的查询降到 0.02 秒,整站后台响应时间从 4 秒回到 800 毫秒内。
最后提醒一个误区:慢查询日志只记录语句执行耗时,不覆盖连接数耗尽、内存不足导致的卡顿,也不覆盖带宽跑满、丢包等网络波动。站点若是”间歇性完全卡死”而非”持续偏慢”,还要配合 SHOW ENGINE INNODB STATUS 查看锁信息和内存水位。
总结与行动建议
总结一下排查链路:确认环境类型 → 开启日志 → 跑够 24 小时聚合分析 → 逐条优化并用 EXPLAIN 验证。一般来说,多数慢查询问题靠补索引和改写语句就能解决,不必先升级硬件。环境选型可参考 虚拟主机与 VPS 的全维度对比,速度优化思路可参考 影响美国 VPS 服务器速度的因素与优化指南。
给你的落地建议:虚拟主机用户先执行 SHOW VARIABLES LIKE 'slow_query%' 确认现状,没开就提交工单或用 SAVEQUERIES 兜底;VPS 用户把配置写进 my.cnf,阈值从 1 秒起步,跑 24 小时后用 mysqldumpslow 输出前 5 条最慢语句逐条优化。如果你需要一台支持完整 root 权限、对数据库优化更友好的 VPS,可以考虑了解一下 Hostease 的美国 VPS 方案,CN2 线路对大陆访问更友好。
延伸阅读: 美国 VPS 选购指南:五大指标一次看懂
最后的建议:把慢查询日志当作数据库的常规体检项目,每月跑一次聚合分析,别等卡了才临时抱佛脚。