TL;DR:单次 st 高不算数,证据链才算数
不少坛友拿着一张 top 截图来问:st 都到 8 了,是不是被超售了?这篇就解决这个疑问:如何用一套可复现的证据链,把”宿主机超售”和”邻居临时噪声”、”自己负载失控”三种情况分开。结论先行——只看单次数值基本都会误判,真正的判定依据是三条线:st 的时段分布是否有规律、同宿主机多台 VPS(Virtual Private Server,虚拟专用服务器,圈内俗称小鸡)是否同步劣化、以及与你自己的历史基线偏离多少。三条线都指向同一个方向,才有资格下”超售”的结论。上一篇 BGP 线路高峰期表现分析 聊的是线路层瓶颈,这篇专注计算层,两层问题经常被混为一谈,先分清楚再动手。
先把概念掰开:超售、st 和邻居噪声不是一回事
超售(Overselling)指服务商在一台宿主机上卖出的 vCPU 总数超过物理核心数。比如 32 核物理机开出 15 台 4 核的小鸡,总承诺 60 核对着 32 个物理核——只要大家不同时满载,这台机器照样跑得稳,这也是超售本身并不违规、反而是低价 VPS 商业模式根基的原因。问题出在”超售比例失控加调度不均”:当同一批邻居长期高负载,你的虚拟 CPU 就得排队等物理核,等待时间在系统里被记为 steal。
top 和 vmstat 里的 st(steal time,被宿主机拿走的时间片占比)就是这条排队记录。需要澄清的是,st 的直接含义是”你没抢到物理核”,至于抢不到的原因——是邻居在压测、是宿主机自身的管理进程在吃资源、还是超售率太高导致僧多粥少——单看这个数字回答不了。论坛里大量争吵正是把这三者混在一起:有人 st 偶尔到 10 就喊被坑,也有人长期 st 3-5 却稳如老狗。差异不在数值大小,而在规律性,这正是下面证据链要解决的问题。
采样怎么做:连续记录比单次截图值钱十倍
排查的第一步不是看某一次 top,而是攒出至少 3 到 7 天的连续采样。做法很朴素:用 cron 每 5 分钟抓一次 vmstat 的 st 列存进日志。核心命令一行:
vmstat 1 3 | tail -n 1 | awk '{print strftime("%F %T"), $17}'
这里第 17 列就是 st 值(不同系统列位可能差一,先跑一次 vmstat 对照表头确认)。把这一行挂进 crontab,每 5 分钟执行一次,几天后你手里就有一张完整的”时间-偷取率”曲线,而不是碎片印象。有条件的也可以用 collectd 或 node_exporter 画 node_cpu 曲线,重点是数据连续。
证据链第一条:看时段分布,规律性暴露问题性质
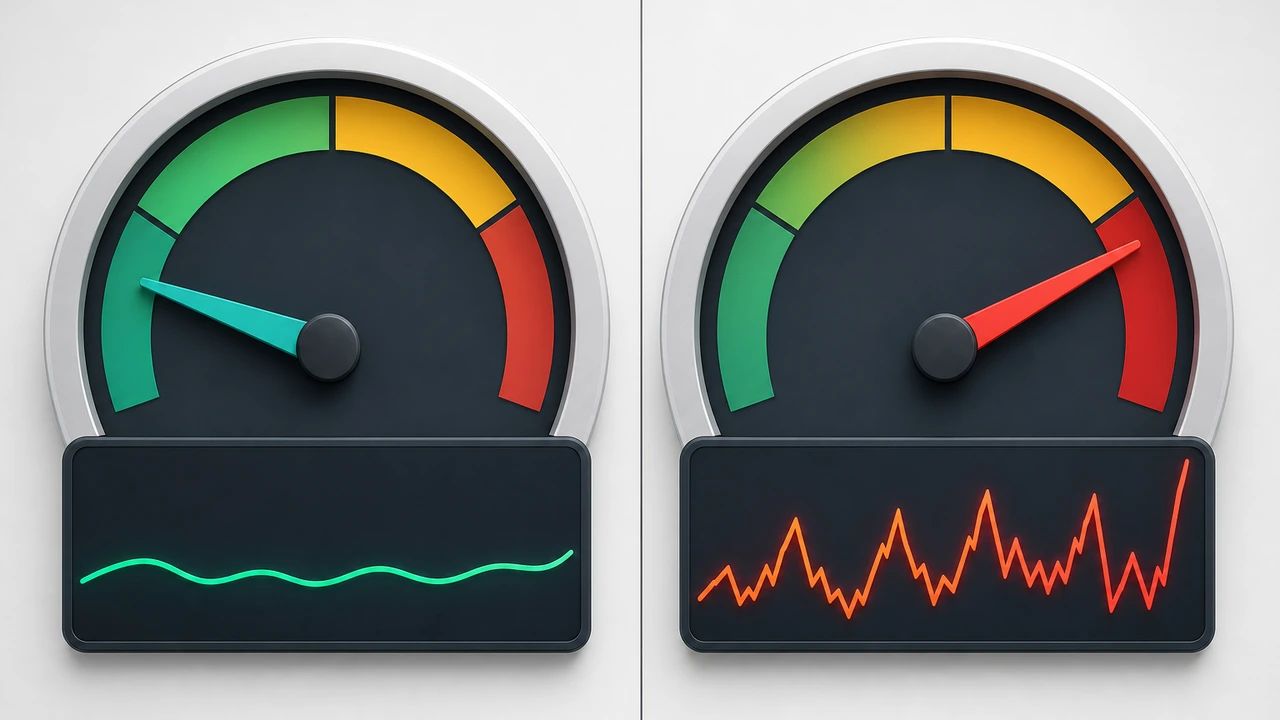
拿到几天数据后先画分布。经验阈值可以参考:st 长期低于 5,属于虚拟化环境的正常呼吸,不用管;st 在 5 到 15 之间且集中在固定时段(比如每晚 8 点到 11 点),说明邻居负载有作息,超售存在但尚在可控范围;st 长期高于 15 且全天无规律飘高,才是典型的”宿主机塞太满”,这时候继续观察的意义已经不大。
我拿两台同价位的美国机房 VPS 做过一轮对比采样:A 机器 st 中位数 2.1,晚高峰爬到 6-8,凌晨回落到 1 以下;B 机器 st 中位数 9.4,凌晨和白天没有明显差别,极值能到 22。A 的表现符合”邻居晚高峰看视频跑脚本”的作息模型,虽然被超售但日常使用几乎无感;B 则是宿主机本身资源长期透支,属于需要行动的对象。两者单看某一次 top 截图可能数值接近,时段分布一拉出来高下立判。
证据链第二条:多机交叉,分清”我的锅”还是”宿主机的锅”
st 只反映你自己没抢到核,不区分原因。交叉验证的办法是在同账号、同机房再开一台最低配的小鸡(月付几块钱的临时工,价格截至 2026 年 9 月,以官网实时价格为准),空闲状态放着,和主机器同时采样两周。如果两台机器的 st 曲线同步起伏,说明压力来自宿主机层面——不是你的进程造成的;如果只有主力机 st 高而哨兵机一直干净,先回头查自己:crontab 里的备份压缩、日志分析脚本、被入侵后植入的挖矿进程,都会以 st 的形式误导你。这一步做完,责任边界基本就清楚了。同样的交叉思路在 美国服务器跨境访问实测 里也用过,用对照节点排除变量是排查类问题的通用套路。
证据链第三条:和自己的基线比,判断是恶化还是一直如此
第三条线容易被忽略:机器刚开通时就该记录一次冷基线——空载 st、UnixBench 单核分数、1K 文件随机读写延迟。三个月后同条件复测,如果 st 中位数从 1.8 涨到 11,说明宿主机在持续加塞客户,服务质量在滑坡;如果从第一天起就是这个水平,那是你买的这个价位段本来如此,抗议的意义不大,换更高档的产品线更实际。基线数据还有个附带好处:向服务商提交工单时附上前后对比,比一句”我的机器卡”有说服力得多,处理优先级完全不同。
三个真实误判案例,帮你避开同样的坑
案例一:坛友的电商站每晚 9 点卡死,top 里 st 冲到 12,直接开工单骂超售。我让他跑了 24 小时采样,发现 st 高的时段和他自己的 MySQL 全量备份任务完全重合——备份线程把虚拟核占满,宿主机调度器只好削减他的时间片,看起来像 steal,本质是自家资源打架。把备份挪到凌晨 4 点后,st 回到 2 以下。
案例二:一位站长发现 UnixBench 分数腰斩,st 却只有 3,怀疑超售。实测排查发现是磁盘 I/O 层的问题:邻居在疯狂读写,宿主机存储队列拥塞,CPU 还没轮到抢就先卡在了等盘上。这类情况 st 不敏感,得看 iostat 的 await 和 util% 才能定位,存储超售比 CPU 超售更隐蔽。
案例三:两台不同商家的机器,A 的 st 常年 8 但跑分稳定,B 的 st 常年 3 但一到晚高峰 SSH 都卡。区别在于 A 的宿主机核多、调度公平,偷的是零头;B 的宿主机核少、单核性能弱,偷得少但每次偷走的都是关键时间片。所以 st 数值要和体感、跑分放在一起看,单一指标定不了案。
判定矩阵:三条证据怎么组合出结论
把三条线收拢成一张决策表,对照自己的数据对号入座:
| 时段分布 | 多机交叉 | 基线对比 | 结论与动作 |
|---|---|---|---|
| 集中晚高峰,峰值 <15 | 哨兵机同步轻微升高 | 与冷基线持平 | 可控超售,调优自愈,不必折腾 |
| 全天无规律 >15 | 哨兵机同样高 | 明显劣化 | 宿主机超载,提工单附数据 |
| 与自身任务时段重合 | 哨兵机干净 | 持平 | 自家负载问题,错峰或调优 |
| st 低但卡顿 | 哨兵机干净 | 磁盘 I/O 劣化 | 存储层瓶颈,查 iostat 再定 |
这张表的用法是从左往右逐列核对,任何一列出现矛盾就回到对应章节重测,不要跳步下结论。
证据齐了之后:工单、修复与迁移的三种走向
证据链指向宿主机超载时,先走工单通道。工单里放三样东西:7 天 st 采样图、同机房哨兵机的对照数据、冷基线与当前的跑分对比,并明确诉求——是希望迁移到负载更低的宿主机,还是仅确认问题。这样写的工单通常 24 小时内会有实质回应,而”机器卡,快修”式的投诉大概率换来重启建议。
服务商的反馈分三种情况处理:愿意免费迁移宿主机的,迁移后重新建立基线再观察一周,确认 st 中位数回到 5 以下;只肯重启或搪塞的,视合同周期直接进入迁移准备——低峰期同步数据、切换 DNS(Domain Name System,域名解析服务)解析、旧机保留 72 小时回退窗口;问题出在自家负载的,回到调优路线,把 cron 任务错峰、加缓存层、升级配置三选一,别把时间浪费在和客服对线。
总结:把判断权交给数据,不是交给情绪
总结一下这篇的核心方法:宿主机超售不是一个数值能定案的事,而是时段分布、多机交叉、基线对比三条证据共同指向的结论。st 低于 5 大可放心,5 到 15 看规律,高于 15 且全天无规律就该行动;行动之前先用哨兵机排除自身原因,用工单数据代替情绪,用基线对比区分”一直如此”和”正在恶化”。
最后给三条建议:第一,每台新机器开通当天就建档记录基线,三个月后的你会感谢这个习惯;第二,预算敏感的项目可以接受可控超售,把省下的钱花在关键业务机器上,业务分级比全线上高配更划算;第三,如果反复排查后确认需要换服务商,建议优先考察目标商家的超售策略与口碑再下单,同价位段里 Hostease 这类支持中文工单的服务商,至少在沟通证据链时不用来回翻译,处理效率高出一截。如果你需要更系统的选型思路,可以参考之前的 云服务器(Cloud Server,弹性可扩缩的虚拟计算资源)选型指南,结合本文的证据链方法,基本能避开绝大多数”卡顿罗生门”。